投稿
新型コロナ感染者数と国際学力調査データで統計的に遊んでみた

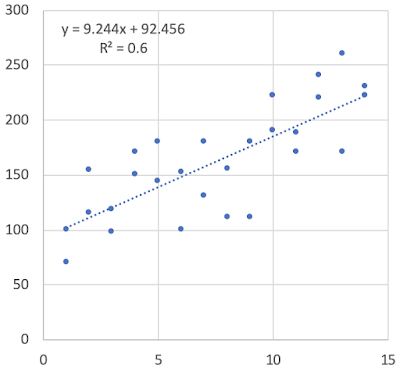
きっかけは,「感染爆発している国の連中は,人の話を聞かない奴が多い」という偏見 新型コロナ騒動は収まりそうもありませんね. ついに緊急事態宣言が全国に広まりました. 私はというと,そんなことはどうでもいい生活をしています. ここ数日は温泉掘りに熱中してたりする. ■ 暇つぶしに自宅で温泉を掘りあてた その後,この採水所はかなり大きくなっていて,湧水だけでお風呂を沸かせそうです. ヒノキ林から湧いてるんだから,ヒノキ風呂にするのがいいかもね. コロナ騒動の給付金として一人当たり10万円もらえるらしいから,ポンプとタンクの設置に費やそうかと思っています. ※この話の続報はまた後日... さて,そんなこんなで温泉を掘っている時に話題になったのが, 新型コロナで感染者数が激増している国に共通していることは何か? ということ. 誰とは言いませんが, 「感染爆発を起こしている国は,どうも,人の話を聞かない気質の奴らが多いんじゃないか」 と言い出した人がいるんです. まあ,オブラートに包まず言えば,頭の悪い奴らが多いんじゃないかと. だったらそれをデータで確認してみようと,各国国民の「頭の良さ」とか「学力」との関連性を見てみようと思ったんです. 学力調査と言えば,OECD生徒の学習到達度調査(PISA)が有名ですが,でもこれは子供の学力調査,わけても学習到達度調査であって,各国の国民性を窺い知れるような学力調査とは言い難いですよね. そこで,同じくOECDが実施している国際成人力調査(PIAAC)との関連性をみてみたんです. PIAACについての詳細は,文部科学省のホームページとかウィキペディアを御覧ください. ■ 国際成人力調査(PIAAC:ピアック) (文部科学省HP) ■ 国際学力調査 (Wikipedia) 実はけっこう関係性が強いかも PIAACのデータは,2つの領域で評価されています. 「数的思考力」と「読解力」です. 2013年に公開されたデータがあります. 当時は,私もこの結果を記事にしました. ■ PIAACとPISAの結果の考察 ちなみに,数的思考力と読解力のランキングはこちらです. なんと,いずれにおいても日本は2位以下と統計...
相関係数を理解する|ウィキペディアを読んでもチンプンカンプンな人のための解説
詳しくはあとで勉強するから,とりあえず今は大事なところだけおさえておきたい そんな人のための解説です. 学生に「ウィキペディアでも詳細なことを書いているから,それを読んで勉強しなさい」と言っても,そもそもウィキペディアに書いていることがチンプンカンプンという場合もあります. こういう学生は,「じゃあ教科書を読みなさい」と言っても読まないことが多く,たいていネットで調べようとします(ネットですら調べないこともあるけど). なので,そんな 「ネットに落ちている解説」 としてここに述べたいと思うわけです. では今回は「相関係数」について. 相関係数について,ウィキペディアでは以下のように解説しています. ■ 相関係数 (Wikipedia)2019.12.9現在 相関係数(そうかんけいすう、英: correlation coefficient)は、2つの確率変数の間にある線形な関係の強弱を測る指標である。相関係数は無次元量で、−1以上1以下の実数に値をとる。相関係数が正のとき確率変数には正の相関が、負のとき確率変数には負の相関があるという。また相関係数が0のとき確率変数は無相関であるという。 (中略) 普通、単に相関係数といえばピアソンの積率相関係数を指す。ピアソン積率相関係数の検定は偏差の正規分布を仮定する(パラメトリック)方法であるが、他にこのような仮定を置かないノンパラメトリックな方法として、スピアマンの順位相関係数、ケンドールの順位相関係数なども一般に用いられる。 (中略) 相関係数は、あくまでも確率変数の間にある線形な関係の尺度に過ぎない。また、確率変数間の因果関係を説明するものでもない。相関係数は順序尺度であり比尺度ではないので、例えば「相関係数が0.2と0.4であることから、後者は前者より2倍の相関がある」などと言うことはできない。 まあ,たしかによく分かりませんよね. こういうのは正確な解説かもしれませんが,初学者が知りたいことではないのです. 相関係数は散布図で考える ウィキペディアのページにも掲載されていますが,「相関係数」は散布図で示されることが多いです. 以下のような散布図がよく見られます. 論文などを読んでいても,よく目にするこ...
現状最強|多重比較のなかで最も検出力の高い「ペリの方法」をエクセルでやる

テューキー・ウェルシュ法とニューマン・コイルス法による「ペリの方法」 以前,一つの多重比較法としては最大の検出力を持つ, 「テューキー・ウェルシュ法」 をエクセル上で行う方法を紹介しました. ■ 最も検出力が高いとされる多重比較|テューキー・ウェルシュ法をエクセルで算出する 今回は,このテューキー・ウェルシュ法の手順に「ニューマン・コイルス法」を重ね合わせることで,さらに甘い結果を出す手法, 「ペリ(Peritz)の方法」 をご紹介します. ほぼ,t検定を繰り返した結果と同じと言っていいくらい甘い多重比較です. しかし,検定の多重性を考慮していることは間違いないので,誰からも文句は出ません. よほど「ペリの方法」が気に入らない統計学者がイチャモンをつけてこない限り,安心して使っていいものです. どうしても統計学的な有意差があることを訴えたい場合で,テューキー法やボンフェローニ修正では有意性が検出されなかった場合に,エクセルで一手間かければOKです. では早速,その手法から説明します. 以下の記事を読んでも不安がある場合や,元の作業ファイルで確認したい場合は, このリンク先→「 統計記事のエクセルのファイル 」から, 「テューキー・ウェルシュ法」 のエクセルファイルをダウンロードしてご確認ください. ※ペリの方法は「エクセル上で算出する」タイプの方法ではありませんので,テューキー・ウェルシュ法のファイルをご活用ください. 「ペリの方法」をエクセルでやる 例データは以下のようなもの. まずは「テューキー・ウェルシュ法」の結果を出さなければいけませんので, テューキー・ウェルシュ法の記事 ■ 最も検出力が高いとされる多重比較|テューキー・ウェルシュ法をエクセルで算出する を見て,そこで算出済みというところからスタートします. 例となるデータは,以下の状態まで算出済みということをご確認ください. (例示しているデータは,テューキー・ウェルシュ法の記事と完全に同じものです) ペリの方法は,このテューキー・ウェルシュ法の結果とニューマン・コイルス法の結果を重ね合わせるものなので,ここにニューマン・コイルス法を算出する必要があります. と言っても,ご存知の方も...
とにかく簡単に「多重比較が必要な理由」と「何を計算しているのか」を知りたい

統計学に興味があるわけではなく,研究テーマに興味がある 統計学を専門にしているわけでもない限り,多くの学生は統計処理作業に興味津々で取り組むということはありません. 学生たち(だけに限らず,多くの研究者たち)は,データの分析手法や処理手順ではなく,研究課題やテーマの解釈に興味があるのです. しかし,そうは言っても統計学をある程度理解しておかなければ正しい解釈や考察はできません. なので,「ある程度」の理解が必要なのですが,この「ある程度」の理解のための解説がけっこう少ない. 今回は, 「多重比較について,正確で緻密な解説でなくてもいいから,とにかくザックリ知りたい」 という人のための記事です. 計算式を一切使わない多重比較の説明 2つの群間の平均値を比較したいという場合,t検定だけで済んでいました. こんな感じで,2つの平均値を比較すればOKだったのです. ところが,3群以上になると,t検定だけではなく「多重比較をしろ」と言われてしまいます. どうして多重比較をしなければいけないのでしょうか? これについて多くの統計学の教科書やネット記事では, 「その理由は,この計算式で表される」 と言い放って終わりであるケースが多いですね. いえ,それが実際正しいわけですけど, 「数字に弱いけど,なんとか頑張って研究している」 という人にとっては,統計学の理解の足かせになってしまいます. そこで今回は,計算式を一切使わずに説明します. そもそも,t検定では何をしているのか? 多重比較の説明をするには,そもそもt検定がどんな計算をしているのか知る必要があります. しかし,上で約束したように,この記事では計算式で説明することはしません. 以下をご覧ください. 調査したり実験したりして得られたデータとは,以下の図のような感じになっています. 青丸1つが1個のデータだと解釈してください. この例図では65個の点. つまり,65人分とか,65回分とか,65匹分のデータということです. そして,「平均値」「標準偏差」と呼ばれている部分も,そこに示したところになります. 平均値を中心として,全データ個数の68%分が入る範囲を...